Akawa

ETY001的博客

今天发现了一个有意思的工具 —— 青龙面板

平时经常会有一些零零碎碎的脚本需要运行,放在宿主机运行,就要安装 nodejs 的环境,如果放在 docker 里运行,就要写 Dockerfile ,太繁琐。

使用这个青龙面板,相当于直接拥有一个容器空间,自带 python, nodejs 环境。可以理解为是云服务商的那种 server less 服务。

有这些特性很方便

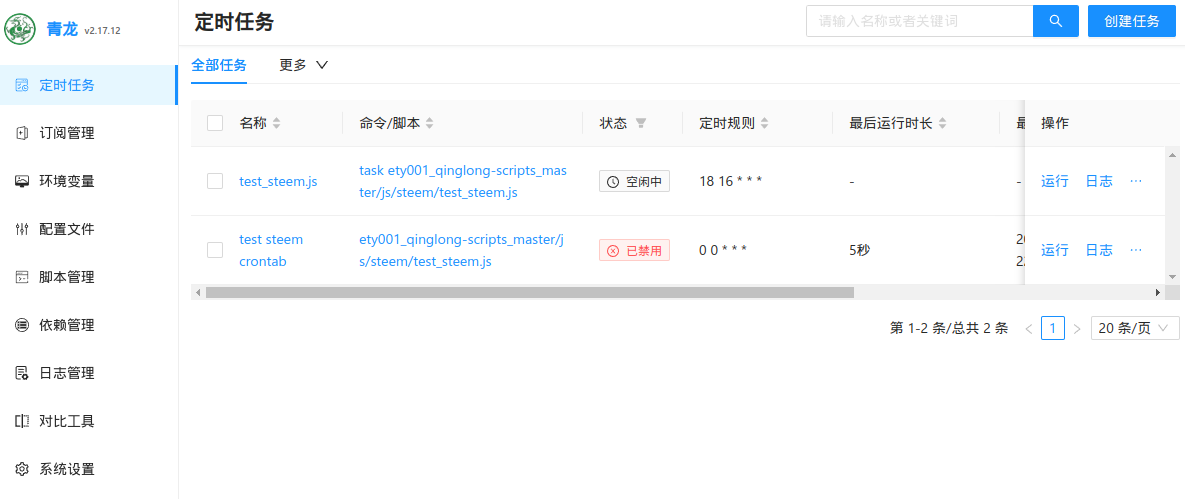
1.按计划拉取指定的 repo 的指定分支。

image.png

这样我们可以把零碎的脚本放在一个独立的代码库里面,进行版本管理。

当然,如果你想要立即执行拉取任务,也提供了单独的运行按钮可以立即执行。

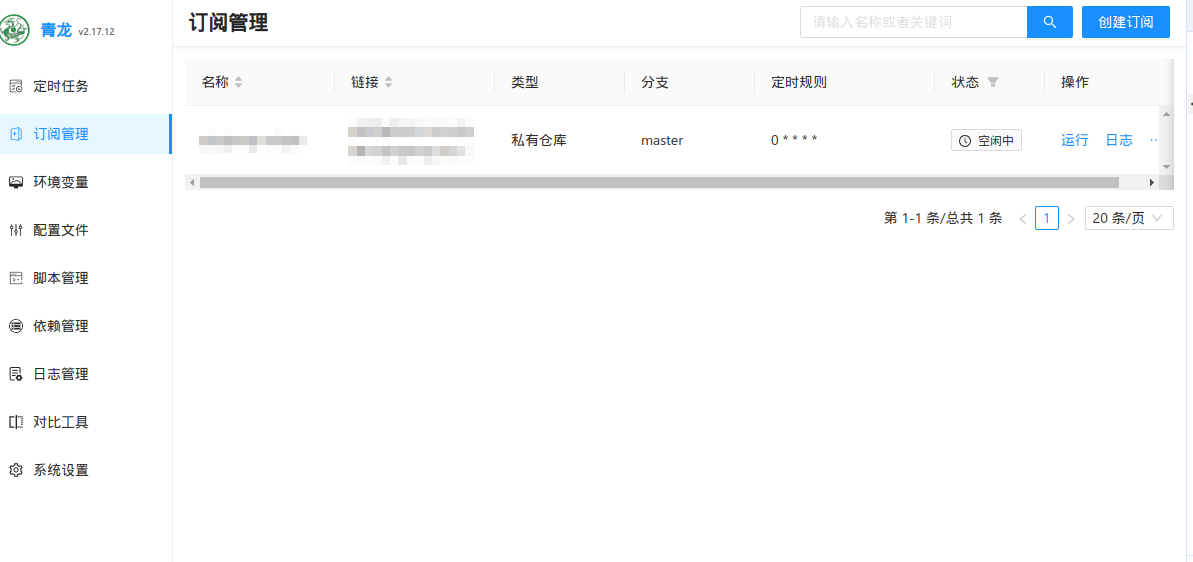
2.共享依赖。

06bbe3ec9a2257829a8383ed4c432d88.jpg

独立的依赖管理面板,可以只需要安装一次依赖,就可以所有脚本都使用。

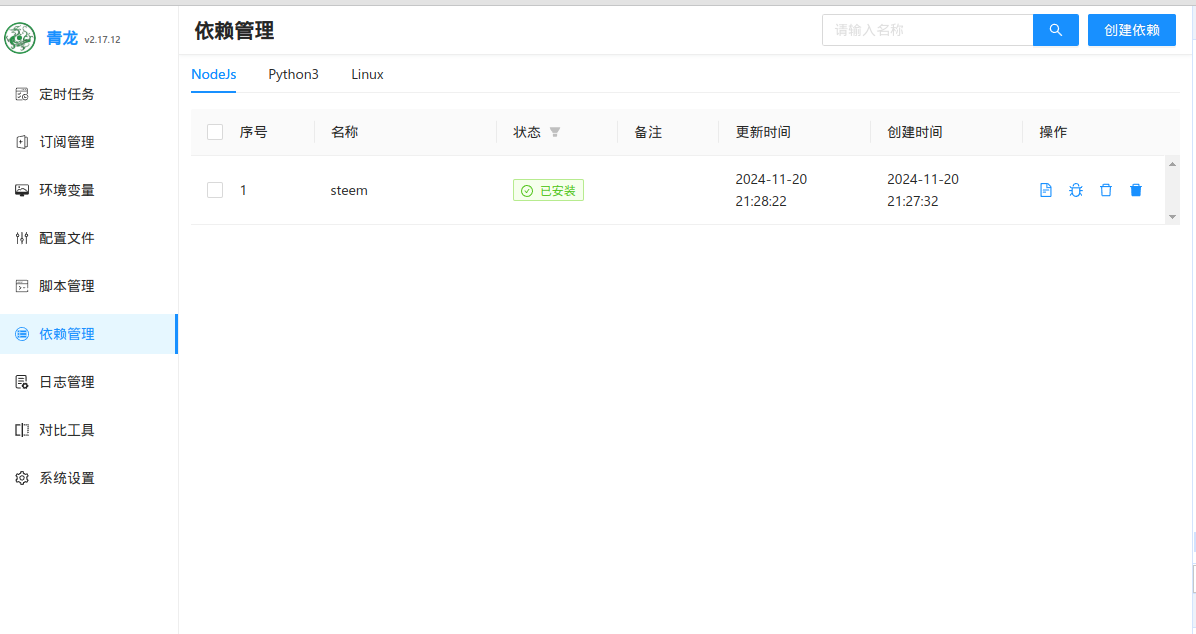
3.在线编辑/调试代码。

image.png

这是拉取下来的代码,可以在线编辑。

image.png

这是调试界面,可以实时调试。

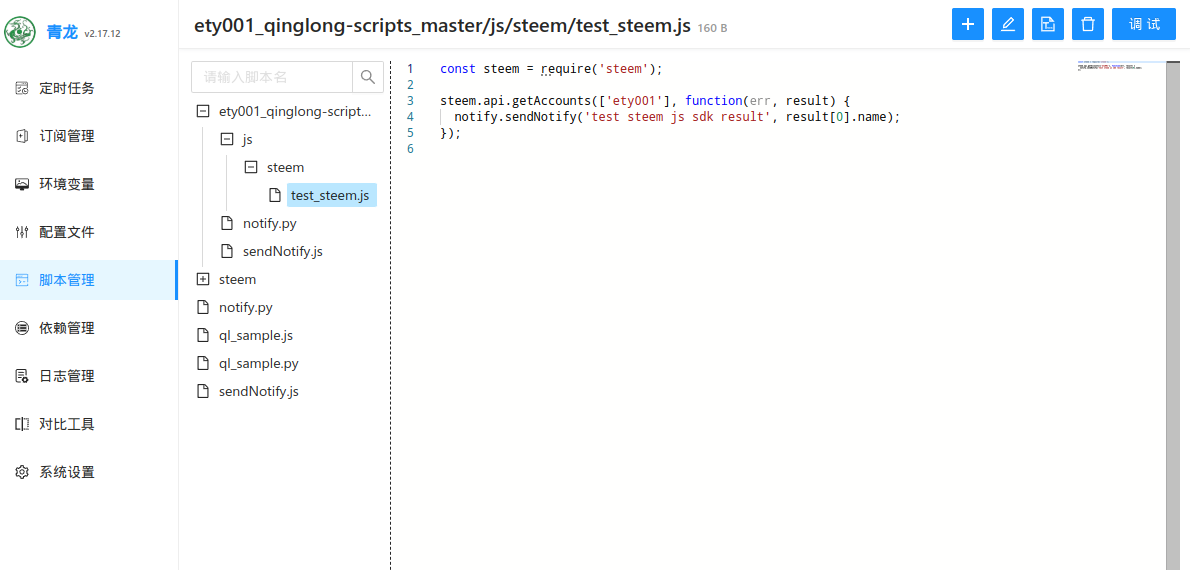
4.核心功能——计划任务

image.png

编辑好的脚本,可以在这里设置计划任务,让脚本按计划运行。

在 React 中,useEffect 的依赖项决定了其什么时候执行。

基本语法

useEffect 接受两个参数:

  • 副作用函数:在组件渲染后或依赖项发生变化时执行的函数。
  • 依赖项数组(可选):决定副作用函数何时重新执行。
1
2
3
useEffect(() => {
// 副作用逻辑
}, [dependency1, dependency2, ...]);

依赖项的常见场景与解释

1.无依赖项数组(每次渲染都会执行): 如果不传入依赖项数组,useEffect 中的副作用函数将在每次组件渲染后都执行。

1
2
3
useEffect(() => {
console.log('This runs after every render');
});

场景:这种用法不常见,通常用于希望在每次渲染时执行某些逻辑,但要注意性能开销。

2.空依赖项数组(只在组件挂载和卸载时执行): 如果传入一个空数组 [],则 useEffect 只会在组件挂载时运行一次,并在组件卸载时运行清理函数(如果提供了)。

1
2
3
4
5
6
useEffect(() => {
console.log('This runs only on mount');
return () => {
console.log('This runs on unmount');
};
}, []);

场景:通常用于初始化数据(例如组件挂载时的 API 请求),或在组件卸载时执行清理操作(例如清理定时器、取消订阅等)。

3.具有依赖项的数组(依赖项变化时执行): 当传入特定的依赖项时,useEffect 只有在这些依赖项的值发生变化时才会重新执行。

1
2
3
useEffect(() => {
console.log('This runs when count changes');
}, [count]); // 当 count 变化时副作用重新执行

场景:用于根据某个特定状态或 prop 变化来执行副作用逻辑。例如,当 count 变化时,可能需要重新获取某些数据或触发其他副作用。

4.多个依赖项: 可以在依赖项数组中传入多个依赖项,useEffect 将会在其中任何一个依赖发生变化时重新执行。

1
2
3
useEffect(() => {
console.log('This runs when count or user changes');
}, [count, user]);

场景:用于当多个状态或 prop 变化时,重新执行某个逻辑。例如,可能需要在 count 或 user 变化时重新发起某个 API 请求。

如何选择依赖项

1.依赖项的选择要遵循以下原则:

  • 副作用函数中使用的所有外部变量:任何在 useEffect 中使用的外部变量(函数组件中的状态、props 等)都应该作为依赖项传入。这是因为这些变量在每次渲染时都可能更新,你需要确保 useEffect 在依赖的值发生变化时执行。
  • dispatch 和其他稳定函数:通常像 dispatch(来自 useDispatch)这样的函数引用是稳定的(即在多次渲染之间不会改变),所以可以安全地放入依赖项数组中。如果某个函数引用在不同渲染周期中保持不变,就可以把它作为依赖项。

2.常见的误区与优化:

  • 忘记依赖项:如果 useEffect 中依赖的某些值没有包含在依赖项数组中,可能会导致副作用函数使用了过时的值(也称为“闭包陷阱”)。例如,依赖于某个 state 却没有将其加入依赖项数组,这样的结果是 useEffect 中的逻辑不会随着 state 的变化重新执行。
  • 过度依赖不必要的变量:有时候不小心将不必要的变量放入依赖项数组,导致 useEffect 过于频繁地执行,浪费性能。例如,不必要地将某些稳定的变量放入依赖项。

ET碎碎念,每周更新,欢迎订阅,点赞,转发!


好用不贵的VPS推荐

https://1hour.win
前情

Steemit 的几个前端项目(condenser, wallet, faucet)都使用了 redux 和 redux-saga。

这次升级 faucet 所有依赖库,发现新版本 redux 推荐使用官方的 @reduxjs/toolkit 工具集来实现 redux 的功能。

既然 redux 的官方推荐使用工具集,那么这次升级我们也要相对应的把原有的 redux 相关代码做改动。

其中,为了应对复杂的异步请求而引入的 redux-saga,我不是很确定是否与工具集兼容,因此投入了时间来研究了一下。

如何将 redux-saga@reduxjs/toolkit 一起使用

  • 创建 Redux Store: @reduxjs/toolkit 提供了 configureStore 来简化 store 的创建过程。你可以将 redux-saga 中间件添加到 store 中。

  • 创建并运行 Saga 中间件: 使用 redux-sagacreateSagaMiddleware 来创建 saga 中间件,然后将其添加到 configureStore 中。

  • 运行你的 Saga: 在 configureStore 创建 store 后,使用 sagaMiddleware.run 来启动你的 saga

下面是简单的例子。

store.js 文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// store.js
import { configureStore } from '@reduxjs/toolkit';
import createSagaMiddleware from 'redux-saga';
import rootReducer from './reducers'; // 你的 reducer
import rootSaga from './sagas'; // 你的 saga

// 创建 Saga 中间件
const sagaMiddleware = createSagaMiddleware();

// 配置 store 并添加 saga 中间件
const store = configureStore({
reducer: rootReducer,
middleware: (getDefaultMiddleware) =>
getDefaultMiddleware().concat(sagaMiddleware), // 添加 saga 中间件
});

// 运行 rootSaga
sagaMiddleware.run(rootSaga);

export default store;

saga.js 文件

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// sagas.js
import { call, put, takeLatest } from 'redux-saga/effects';
import axios from 'axios';

// worker saga
function* fetchUser(action) {
try {
const response = yield call(axios.get, `/api/user/${action.payload.userId}`);
yield put({ type: 'USER_FETCH_SUCCESS', payload: response.data });
} catch (error) {
yield put({ type: 'USER_FETCH_FAILURE', error: error.message });
}
}

// watcher saga
function* rootSaga() {
yield takeLatest('USER_FETCH_REQUEST', fetchUser);
}

export default rootSaga;

ET碎碎念,每周更新,欢迎订阅,点赞,转发!


好用不贵的VPS推荐

https://1hour.win
由于 faucet 项目全部是手动搭建的环境,所以在把 react15 升级到 react18 后,

1
2
3
4
5
import { createRoot } from 'react-dom/client';

const appElement = document.getElementById('app');
const root = createRoot(appElement);
root.render(<h1>Hello, world</h1>);

使用上面的代码测试环境是否搭建成功的时候,报 React is not defined 错误。

原因是:在 React 18 中,虽然可以使用 createRoot 来渲染组件,
但仍然需要显式地导入 React 以支持 JSX 语法。

在 JSX 中,<h1>Hello, world</h1> 会被编译成 React.createElement('h1', null, 'Hello, world')
因此,即使你没有直接使用 React,它仍然需要被导入。

由于 babel 我也升级到最新了,在 7.9 版本后,可以使用 @babel/preset-react 来自动引入 JSX 转换。
而不用去显式的导入 React 了。

具体方法就是在 babel.config.js 中对 @babel/preset-react 增加配置如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
{
"presets": [
[
"@babel/preset-env",
{
"targets": "defaults"
}
],
[
"@babel/preset-react",
{
"runtime": "automatic" // 使用自动引入模式
}
]
]
}

如此设置后,再次编译执行,报错就没有了。


ET碎碎念,每周更新,欢迎订阅,点赞,转发!


好用不贵的VPS推荐

https://1hour.win
在 React 18 中,createStoreRedux 提供的一个函数,用于创建 Redux store,但从 Redux Toolkit v5 开始,createStore 已被标记为弃用,并建议使用 configureStore 作为替代。

configureStoreRedux Toolkit 中提供的一个函数,它简化了 Redux 的配置过程,内置了 Redux DevTools、默认的中间件配置等。

下面是如何使用 configureStore 替代 createStore 的一个简单示例:

1
2
3
4
5
6
7
8
import { configureStore } from '@reduxjs/toolkit';
import rootReducer from './reducers';

const store = configureStore({
reducer: rootReducer,
});

export default store;

这次重构 faucet 将会替换掉 createStore 方法。

Redux、React-Redux 和 Redux-Saga 是前端开发中常用的状态管理和异步数据处理工具。它们各自有不同的功能和用途。

1. Redux

Redux 是一个用于 JavaScript 应用的状态管理库。它提供了一种可预测的方式来管理应用的全局状态。

Redux 的核心概念包括:

  • Store: 存储应用的状态,是唯一的数据源。
  • Actions: 是描述状态变化的普通 JavaScript 对象。
  • Reducers: 是纯函数,接收当前状态和 action,返回新的状态。
  • Dispatch: 用于触发 action,从而引发状态的改变。

Redux 的特点:

  • 单一数据源: 整个应用只有一个状态树(store)。
  • 状态是只读的: 不能直接修改状态,必须通过 action 来描述状态变化。
  • 纯函数更新状态: Reducers 必须是纯函数,不得有副作用。

2. React-Redux

React-Redux 是官方提供的 Redux 和 React 的绑定库。它允许 React 组件与 Redux store 进行连接,使得组件能够访问 Redux 的状态并分发 actions。

React-Redux 的特点:

  • <Provider> 组件: 这个组件将 Redux store 提供给应用内所有的组件。
  • connect() 函数: 将 React 组件连接到 Redux store,允许组件从 store 中读取状态和分发 actions。
  • Hooks: useSelector 和 useDispatch 是 React-Redux 提供的 hooks,用于替代 connect(),更符合函数组件的使用方式。

Demo Code

1
2
3
4
5
6
7
8
9
10
11
12
import { Provider } from 'react-redux';
import { createStore } from 'redux';
import App from './App';
import rootReducer from './reducers';

const store = createStore(rootReducer);

const Root = () => (
<Provider store={store}>
<App />
</Provider>
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import React from 'react';
import { useSelector, useDispatch } from 'react-redux';
import { increment } from './actions';

const Counter = () => {
const count = useSelector(state => state.count);
const dispatch = useDispatch();

return (
<div>
<span>{count}</span>
<button onClick={() => dispatch(increment())}>Increment</button>
</div>
);
};

3. Redux-Saga

Redux-Saga 是一个用于处理 Redux 应用中的异步操作的中间件。它基于 ES6 的 Generator 函数,使得处理复杂的异步逻辑(如异步 API 请求、并发请求、失败重试等)变得更直观和可管理。

Redux-Saga 的特点:

  • Sagas: Generator 函数,用于定义异步操作的逻辑。
  • Effects: Redux-Saga 提供了一系列 effects 函数(如 take, call, put 等)用于处理副作用(例如异步调用)。
  • 非阻塞调用: 通过 Generator 的 yield 机制,可以使异步操作的代码写起来像同步代码。

Demo Code

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import { call, put, takeEvery } from 'redux-saga/effects';
import { fetchDataSuccess, fetchDataFailure } from './actions';
import api from './api';

// 定义 Saga
function* fetchDataSaga(action) {
try {
const data = yield call(api.fetchData, action.payload);
yield put(fetchDataSuccess(data));
} catch (error) {
yield put(fetchDataFailure(error));
}
}

// 监听特定的 action
function* watchFetchData() {
yield takeEvery('FETCH_DATA_REQUEST', fetchDataSaga);
}

export default watchFetchData;

总结

  • Redux: 用于管理全局状态,提供一个规范化的状态管理框架。
  • React-Redux: 是 Redux 和 React 的连接工具,让 React 组件可以访问 Redux 的状态和 actions。
  • Redux-Saga: 处理复杂的异步操作,让异步逻辑的管理更加简单和可维护。

这三个工具通常配合使用,以实现复杂的状态管理和异步数据处理。


ET碎碎念,每周更新,欢迎订阅,点赞,转发!


好用不贵的VPS推荐

https://1hour.win
最近在弄faucet 的重构工作,因为要全面使用新的依赖和模式,遇到了很多问题。

比如最近一周一直被 jest 无法在 ESM 模式下工作的问题卡住。

搜索引擎 + chatgpt 多方面的尝试都没有找到有效方案。

直到昨天看到 jest 官方文档里有专门的一页说这个,才搞定问题。

解决方案就是两步。

第一步是用空配置 {} 替换掉之前的 jest.config.jstransform,即关闭 transform

第二步增加环境变量 --experimental-vm-modules,以启用 node 的实验 API,因为 jest 使用的 node 的实验 API 实现的 ESM 支持,这也就意味着,可以卸载掉 babel-jest 插件了。

启用实验 API 这里, jest 官方文档只给了两个 CLI 下的使用例子,而我们的项目使用的是 package.json 中的 scripts 方式。

因此要想在 scripts 里启用,可以按照下面的格式:

1
2
3
"scripts": {
"jest": "NODE_OPTIONS=--experimental-vm-modules jest"
},

每次看完用完,因为别的项目又切换到非 js 语言,过段时间就又忘了,所以写下来总结一下,要不然每次都要现搜索。

使用 import 导入的时候是否加扩展名?

是的,在 ESM 模式下,使用 import 时需要包含文件的扩展名。

这是因为 ESM 模块解析严格遵循文件路径规范,不像 CommonJS 那样自动推断 .js、.json 或 .mjs 等扩展名。

假设有下面的文件结构

1
2
3
4
project/
├── app.js
└── utils/
└── helper.js

在 app.js 中,你需要这样导入 helper.js

1
import { myHelperFunction } from './utils/helper.js';

加 {} 和不加 {} 的区别

在 JavaScript 中,import 语句的语法有两种主要形式:具名导入和默认导入。

加 {} 和不加 {} 的区别在于你是导入模块中的一个具名导出还是默认导出。

1. 具名导入 (Named Import)

1
2
3
4
5
6
7
8
9
10
11
12
13
// utils.js
export const myFunction = () => {
console.log('This is myFunction');
};

export const anotherFunction = () => {
console.log('This is anotherFunction');
};

// main.js
import { myFunction } from './utils.js';

myFunction(); // 输出: This is myFunction

2. 默认导入 (Default Import)

1
2
3
4
5
6
7
8
9
10
11
// utils.js
const myFunction = () => {
console.log('This is myFunction');
};

export default myFunction;

// main.js
import myFunc from './utils.js';

myFunc(); // 输出: This is myFunction

这里对我来说,如果不看文档,纯靠我自己的经验
我一直以为不加 {} 的时候,是把整个文件导出的
也就是按照例子的代码,我的直观感觉应该是 myFunc.myFunction()

之前尝试过好几次,使用 xmodmap 来修改键位,但是都是以失败告终。

每次都是以为懂了,结果都是失败。

最近在一台 Chromebook 上装了 Archlinux,再次尝试调换键位。

想把 Search 键和 左Control 键对换位置。

下面是按键对应的信息

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
--- xev 获取到两个按键的信息 ---
keycode 133 (keysym 0xffeb Super_L)
keycode 37 (keysym 0xffe3 Control_L)

--- xmodmap -pke | grep Control_L 和 grep Super_L 的信息---
keycode 37 = Control_L NoSymbol Control_L
keycode 133 = Super_L Super_L Super_L Super_L Caps_Lock Super_L Caps_Lock
keycode 206 = NoSymbol Super_L NoSymbol Super_L

--- xmodmap -pm 的信息 ---
shift Shift_L (0x32), Shift_R (0x3e)
lock Caps_Lock (0x42)
control Control_L (0x25), Control_R (0x69)
mod1 Alt_L (0x40), Alt_L (0xcc), Meta_L (0xcd)
mod2 Num_Lock (0x4d)
mod3 ISO_Level5_Shift (0xcb)
mod4 Super_L (0x85), Super_R (0x86), Super_L (0xce), Hyper_L (0xcf)
mod5 ISO_Level3_Shift (0x5c)

尝试创建了一份 .Xmodmap 配置如下:

1
2
3
4
5
6
remove control = Control_L
remove mod4 = Super_L
add mod4 = Control_L
add control = Super_L
keycode 37 = Super_L
keycode 133 = Control_L

结果失败了。

不过经过不懈搜索,发现了一个替代方案 – keyd.

这个项目就是为了解决各种键盘问题的,非常感谢这个项目。

同时还找到了一份 针对 Chromebook 的 keyd 配置

通过下面的命令来获取一下按键的名字

1
sudo keyd monitor

根据得到的键位信息,在上面的那份配置的基础上,增加下面的内容

1
2
3
4
5
[main]
....

leftmeta = leftcontrol
leftcontrol = leftmeta

重新载入一下

1
sudo keyd reload

搞定!

咱就说,Linux 下很多东西(iptables啊,X11啊)的配置也不知道为啥搞的很反人类,明明是可以搞的这么简单的啊!

最近我的 BTS 见证人总是收到丢块报警,排查了原因,大概率是因为 API 和 出块都使用同一个程序的原因。

从 Abit 那里了解到,API 请求和出块并没有做线程优先级,所以在有大量 API 请求进入或者长耗时操作的时候,都会对出块造成影响。

对于底层的 C++ 改起来太麻烦,主要我也不会改,所以思路变换一下,那么就在入口位置进行拦截。

最初尝试使用 nginx 的 limit_conn 来限流,但是没有效果。

主要原因是 Websocket 握手建立连接后,就不会再触发规则了,而所有的请求都以 Websocket 的消息形式与后端交互了。

于是换成了 openresty,通过 lua 来建立一个 Websocket 的消息转发机制,符合条件的放行,不符合的拦截。

最终代码越写越复杂,成型的规则就是在 IP 黑名单中的,且 method 也在黑名单里,那么就限流。

具体的代码实现在这里:https://github.com/ety001/openresty/blob/master/scripts/lua/bts/limit_req.lua,可以作为参考。

0%